AI 最大的谎言,是有出处的
零基础长文 · 检索增强生成 RAG
一个 AI 给律师编了六个不存在的判例,律师信了,把它写进了法庭文书,然后被罚了五千美元。我花了几天时间,把背后这套「给 AI 开卷」的技术从头拆到尾。结论稍微有点扫兴,但它比我想的要重要得多。
阅读约 23 分钟
01 · 六个不存在的判例
故事是这样的。
2023年,纽约有个叫 Steven Schwartz 的律师,接了一桩人身伤害的案子。打的是什么不重要,重要的是他要做一件律师这辈子做过一百万次的事,找判例。
他没去 Westlaw,也没去 LexisNexis。他打开了 ChatGPT。
ChatGPT 给了他六个判例。案号有,法官名字有,判决日期有,引用段落有,格式严谨得像从判例集里直接剪下来的。其中一个叫 Varghese v. China Southern Airlines,写得有鼻子有眼,连判赔金额都给了。
Schwartz 把这六条写进了提交给法院的文书里。
然后法官去查了。
六个案子,要么根本不存在,要么被改得面目全非。
法官 P. Kevin Castel 在裁定书里的话大意是,这些引用的案例要么是假的,要么是错的,而且当事人提交的材料里,没有一句是准的。
最后 Schwartz 和另一位律师,连同他们所在的律所,合计被罚了 5000 美元。
你先别急着笑他。
一个受过专业训练、日常工作就是在浩如烟海的信息里挑出「真」的那一条的人,被一个语言模型骗到在联邦法庭上引用了六个不存在的案子。而且法官事先问过他,这些案例是真的吗,他说是。
这事让我想了很久。不是想他蠢,是想一个更基础的问题。
一个专门用来查案例的系统,为什么会编出不存在的案例。
而且,为什么它编得那么像真的。
这句话我先放这儿,后面会用到。
02 · 它不是坏了,它本来就是这么被造出来的
要搞明白这件事,得先接受一个其实挺反直觉的事实。
大语言模型从它被造出来的第一天起,它的目标就不是「说真话」。
它的目标是,猜下一个字。
就这么简单。你给它一段话,它做的事是算概率,下一个字最可能是什么。中文里「中华人民共和」后面接「国」的概率是 99.99%,它闭着眼睛都能猜对。接下去是「成立于」还是「是一个」,它也能猜得八九不离十,因为语料里这些搭配出现过几百万次。
这里的关键在于,它优化的从来不是「这句话对不对」,是「这句话顺不顺」。
顺和真,在绝大多数时候是重合的。因为一个人写「中华人民共和国的首都是北京」,大概率是因为这确实是事实。所以在海量的语料里泡久了,模型确实学会了大量的真知识。
但这两个东西一旦分开,麻烦就来了。
你问它某个人的生日。语料里这个信息可能只出现过一次,甚至压根没出现过。模型没有任何模式可以学,这时候它有两条路。
一条是说,我不知道。
另一条是,给一个「最像人话的答案」。
OpenAI 今年9月发了一篇论文,标题就叫《Why Language Models Hallucinate》,为什么语言模型会产生幻觉。里面把这个机制讲得特别清楚,而且他们用的比喻我很喜欢。
考试。
大部分模型的评测,用的是准确率。给你一道题,答对得分,答错零分。那你答「我不知道」呢,也是零分。
这就跟多选题一样。你不会,空着一定是零分,蒙一个还有四分之一的概率对。所以任何一个理性的考生,都会蒙。
模型也是这么被训出来的。
论文里给了两组数字,我觉得比一万句解释都管用。
一个叫 o4-mini 的模型,准确率 24%,弃权率只有 1%。听起来不错对吧,但它答错的概率是 75%。
另一个叫 gpt-5-thinking-mini 的模型,准确率只有 22%,比上面那个还低。但它的弃权率是 52%,错误率降到了 26%。
你注意这个反差。准确率更低的那一个,反而是更可靠的那一个。
因为它学会了在不知道的时候闭嘴。而前者,它宁愿瞎蒙。
我盯着这两组数看了一会儿,有点想笑,又有点笑不出来。。。
论文里有句话我看了好几遍,大意是,主流评测里的大多数,都在奖励幻觉行为。
所以你看,幻觉这件事,它不是模型坏了,也不是它学艺不精。它是这套「用准确率打分」的机制下,一个必然的产物。你越逼着它别答错,它越倾向于蒙一个。你越奖励它「什么都答得上来」,它就越不肯承认自己不知道。
愚钝如我,之前一直以为幻觉是模型能力不足的表现,想着等模型再大一点、数据再多一点,这问题自然就没了。看完这篇论文我才反应过来,这玩意儿是个制度问题,不是能力问题。
指望模型自己努力,是修不好它的。
那怎么办呢。
既然它闭卷考考不好,那就别让它闭卷考了。
03 · 有人想了个笨办法,让它开卷
RAG 这个词,是 2020 年几个 Facebook AI 的研究员在一篇论文里起的,全称叫检索增强生成,英文 Retrieval-Augmented Generation。
那篇论文的核心想法,朴素得像个笨办法。
既然模型记不住,那就在它答题之前,先把可能用得上的资料塞到它手里。
就这么简单。
还是拿考试打比方。闭卷考,你只能靠脑子里的东西,不会就是不会,一蒙就错。开卷考,你可以翻书。你不需要把整本书背下来,你只需要知道,这道题该翻到哪一页。
RAG 做的就是这个事。它给模型配了一个图书馆,模型答题之前,先去图书馆里借几本书回来,摊在桌子上,看着书写。
你可能会说,这不等于是开卷考嘛,那考出来的成绩还有意义吗。
有意义。而且意义比你想的大。
因为我们绝大多数时候需要的,不是一个能背下整本书的人,是一个知道去哪儿查的人。
医生记不住所有药的剂量,但他会翻药典。律师记不住所有判例,但他会去检索。会计记不住所有税率,但他会去看最新的规定。
一个愿意查资料的人,可信度是高于一个拍着胸脯说「我全记得」的人的。
RAG 就是这个逻辑。它不指望模型什么都懂,它只是给模型配了一间可以随时进去翻书的资料室。
听起来完美。
可惜,开卷考也有开卷考的坑,而且这坑比闭卷还阴。
04 · 开卷考的五步,每一步都能翻车
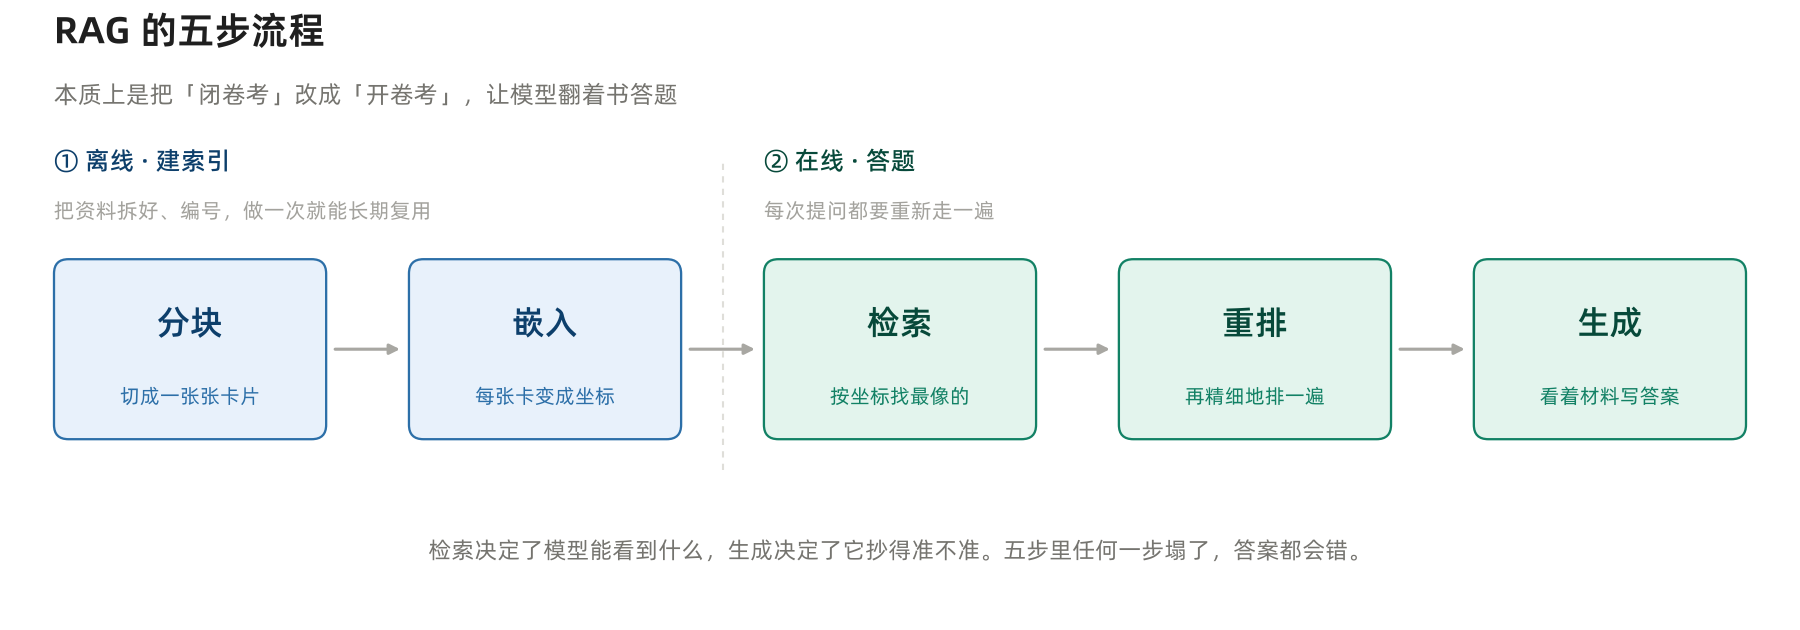
一个完整的 RAG 系统,拆开来看是五步。
我先用「开卷考」这个比喻把它串一遍,然后我们一步一步看它怎么翻车。
第一步,把书拆成卡片。 学名叫分块,chunking。
一整本书是塞不进考场的,得先切成一张张卡片,一张卡讲一件事。这一步听起来毫无技术含量,但它是整个系统里最容易被做坏的一步。
切得太碎,卡片之间就断气了。一句话里有个「他」,你把前半句和后半句切成两张卡,那「他」指的是谁,就永远找不回来了。
切得太大,一张卡里塞了五件事,你检索的时候把它捞上来,模型就得自己从五件事里挑一件,挑错的概率立刻上去。
现在大家在用的一个办法叫父子块。小的那块用来检索,因为小,所以精准。命中之后,把这块所属的那个大的父块喂给模型,因为大,所以上下文完整。有团队做过对比,说这么一改,检索精度能从 54% 提到 81%。
第二步,给每张卡片编一个「意思坐标」。 学名叫嵌入,embedding。
这一步是整个 RAG 里最玄的一步,也是最容易让人产生误解的一步。
它的做法是,用另一个模型,把每张卡片变成一串数字,比如一千五百三十六个数字。这串数字就是这张卡在「意思空间」里的坐标。意思越接近的两张卡,坐标离得越近。
所以你搜「退货政策」,它能把标题写着「退款流程」的那张卡拉出来,哪怕这两张卡一个字都不重合。
这里有个必须记住的坑。
它匹配的是「像」,不是「对」。
「苹果手机怎么退货」和「苹果公司最新财报」,在意思空间里,离得可能比你想的近。都提到了苹果,都跟消费有关。真正决定它们该不该被算作相近的那个维度,可能只占了一千五百三十六个数字里的那么五六个。
我打个不一定恰当但我觉得还挺准确的比方。这一步就像,你让一个从来没见过你的门卫,凭你的照片找人。他能找出很多「长得像」的人,但你要找的那个具体的人是不是在这堆里,他不保证。
第三步,按坐标把最像的几张卡捞出来。 学名就是检索,retrieval。
通常的做法是取前 K 个,比如前 5 个、前 20 个。K 取多少,是个玄学,取少了怕漏,取多了怕杂。
这一步的翻车方式是,正确答案压根没被捞出来。
Anthropic 在开发他们的上下文检索技术时测过一组数据,在干净、经过整理的语料库上,用标准的向量检索,正确答案进不了前 20 名的情况,是 5.7%。
你算算,大概是十八次里有一次。
这还是在数据整整齐齐、没有任何杂质的情况下。
医学领域的一份研究更狠。他们找了 18 个医学专家,做了八万多个标注,测真实的患者问题和考试题。结果是,检索出来的前 16 个段落里,真正跟问题相关的,只有 22%。
也就是说,将近八成的「证据」,是充数的。
那模型呢,它不知道这是充数的。它会把这 16 段全当真,硬着头皮写。
第四步,找个懂行的人把这几张卡重新排一遍。 学名叫重排,reranking。
这一步是为了修第三步的坑。先用向量检索捞一大批候选,再上一个更精细的模型,给它逐条重新打分,把真正相关的那几个顶到前面去。
听着有点绕,但你想想看,一个 HR 先凭简历关键词筛出一百份,再让业务主管逐份细读挑出五个,就是这么一个流程。
而这五张卡排成什么顺序,居然也有讲究。
斯坦福有篇 2023 年的论文,标题叫《Lost in the Middle》,丢了中间。他们做了个实验,把包含答案的那份文档,放在一大堆文档的不同位置上,然后看模型答得对不对。
结果是条 U 型曲线。
答案在最前面,模型答得好。答案在最后面,模型答得也好。答案在中间,模型就瞎了。
20 份文档的测试里,正确答案放在中间位置,准确率会掉 30% 以上。
更狠的是,GPT-3.5-Turbo 在不给它任何文档、纯靠自己的时候,多文档问答的准确率是 56.1%。而你把一份包含答案的文档放在中间,它反而答得比 56.1% 更差。
给了它资料,它反而变笨了。
今年7月,做向量数据库的 Chroma 又往前推了一步。他们测了 18 个模型,包括 GPT-4.1、Claude 4、Gemini 2.5 这些当红的,得出的结论是,所有模型,无一例外,输入越长性能越差。而且这个变差不是到某个临界点突然掉下去,是从一开始就在慢慢往下滑。
他们给这个现象起了个名字,叫上下文腐烂。
所以那句「现在模型上下文窗口都100万 token 了,RAG 该死了吧」的话,你可以先放一放。窗口大小是容量,不是能力。一个能装一万件行李的后备箱,不代表它知道该带哪一件。
第五步,看着这几张卡,把答案写出来。 学名叫生成。
到这儿,模型手里有了问题,有了三到五张它认为是相关的卡片,它要做的是,基于这些材料写一个答案。
五步走完,从「把资料喂进去」到「答案吐出来」,一个 RAG 系统的完整链条就是这样。
你看,每一步都挺聪明的,每一步也都有它自己的翻车方式。而真正的麻烦在于,这些翻车的现场,看起来都特别正常。
05 · 更阴的坑,是它开始抄错
到这里,我得说一个可能让人有点不适的结论。
RAG 没有消灭幻觉。
它做的是,把幻觉换了一个形态。
以前的幻觉,是凭空编。模型从几万亿参数的脑子里搅出一个答案,没有出处。你看着它,心里多少会有点没底,会想着去核对一下。
现在的幻觉,是看着材料编。它手里确实有几张卡,它也确实参考了这几张卡,然后它写出了答案,还附上了引用。
引用是真的。文档是真的。唯独答案是错的。
Vectara 和滑铁卢大学今年做了一套新的评测,叫 FaithJudge,专门测一件事。把相关材料喂给模型之后,它还会不会编。
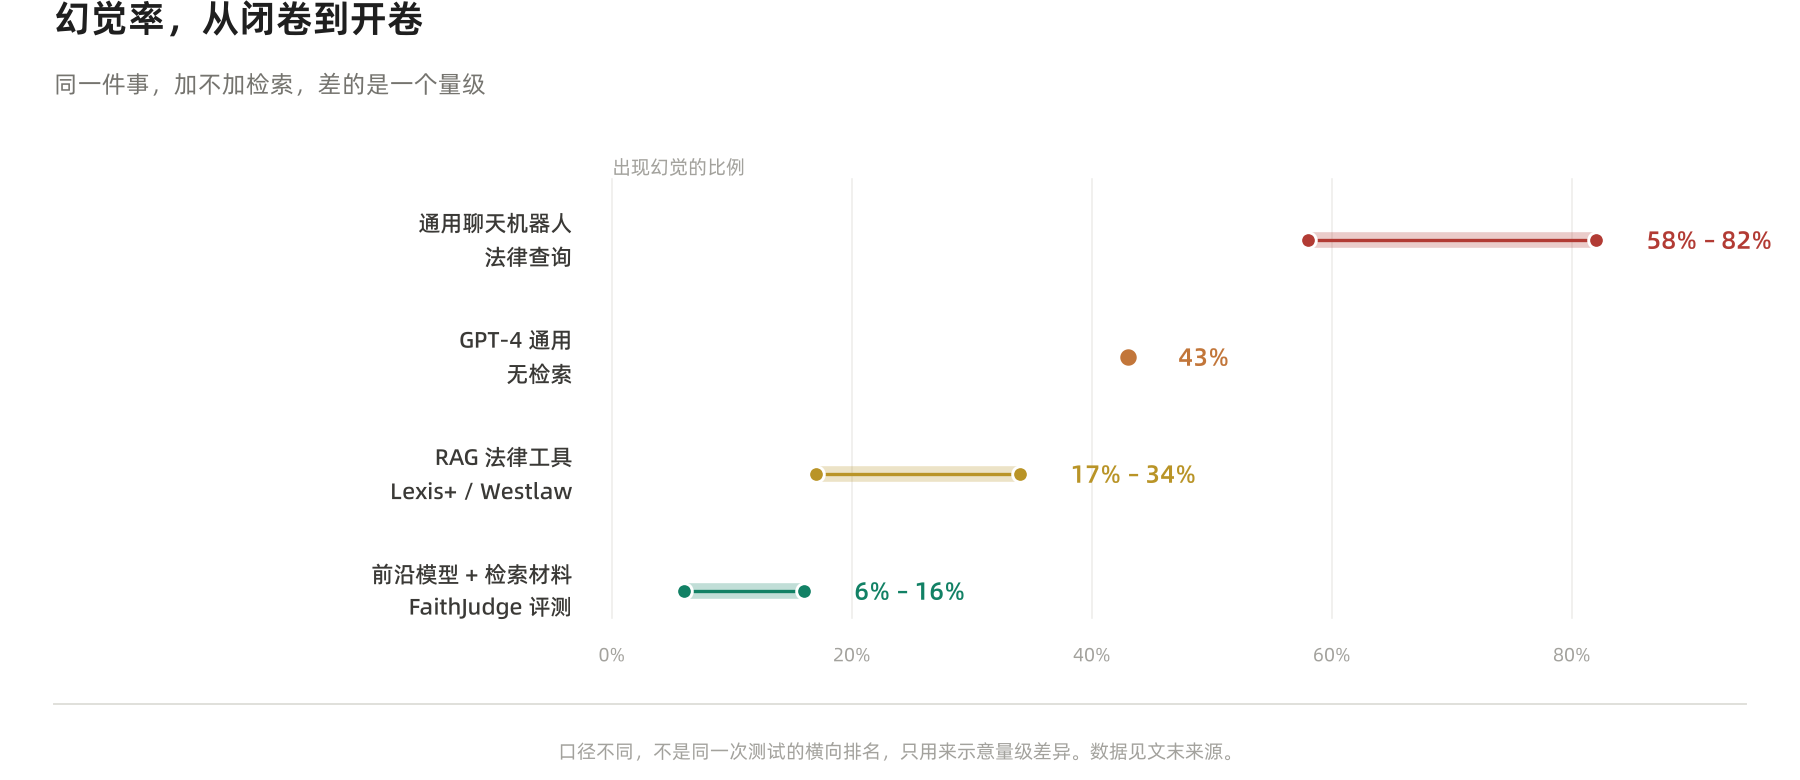
结果是这样。榜单上最好的模型,Gemini 2.5 系列,幻觉率也在 6% 以上。而排在后面的好几个前沿模型,都在 16% 左右。
你注意这个测试的前提。不是让它们凭空答题,是在已经把正确答案递到手上的情况下。
还有一组数据我觉得更吓人。
有个叫 RGB 的评测,专门测一件事。给模型一堆完全不相关的文档,然后问它问题,看它会不会老老实实说「这些材料回答不了这个问题」。
最好的模型,拒答率是 45%。
也就是说,哪怕你塞给它的全是一堆废纸,有一半以上的时候,它还是会硬着头皮给你一个答案。
最后一个。有个叫 ClashEval 的测试,测的是这种情况。检索出来的材料,跟模型自己本来答对的答案冲突了。这时候模型会怎么选。
结果是,超过 60% 的情况下,模型会放弃自己原本正确的答案,去信那条错材料。
我把这三个数字摆在一起的时候,心里是有点发凉的。
因为它描述的是一个我从来没想过的失败模式。
我们过去担心 AI 太能编,太自信,什么都敢说。现在的问题是,它太听话了。
你给它什么,它信什么。你给错了,它照着错的说。它还会把这份错,包装成一份有出处、有引用、条理清晰、语气笃定的答案,递到用户面前。
而用户呢。有研究说,带引用的回答,用户给的信任度反而更高,哪怕这条引用跟问题只有半毛钱关系。
幻觉穿上了西装,看起来比真话还像真话。
这就是为什么我一开始说,那六个不存在的判例比我想的要重要。
Schwartz 那个案子,是闭卷考的失败。他信了一个什么都没有的模型。
而现在更常见的场面是,一个看起来特别规范、每条答案都带引用的 AI 工具,给你一份同样错的答案。你连查的心思都不会起,因为它看起来太扎实了。
06 · 三个案例,看幻觉是怎么穿上西装的
我给你设计三个具体的场面,你可以对着看看自己有没有踩过。
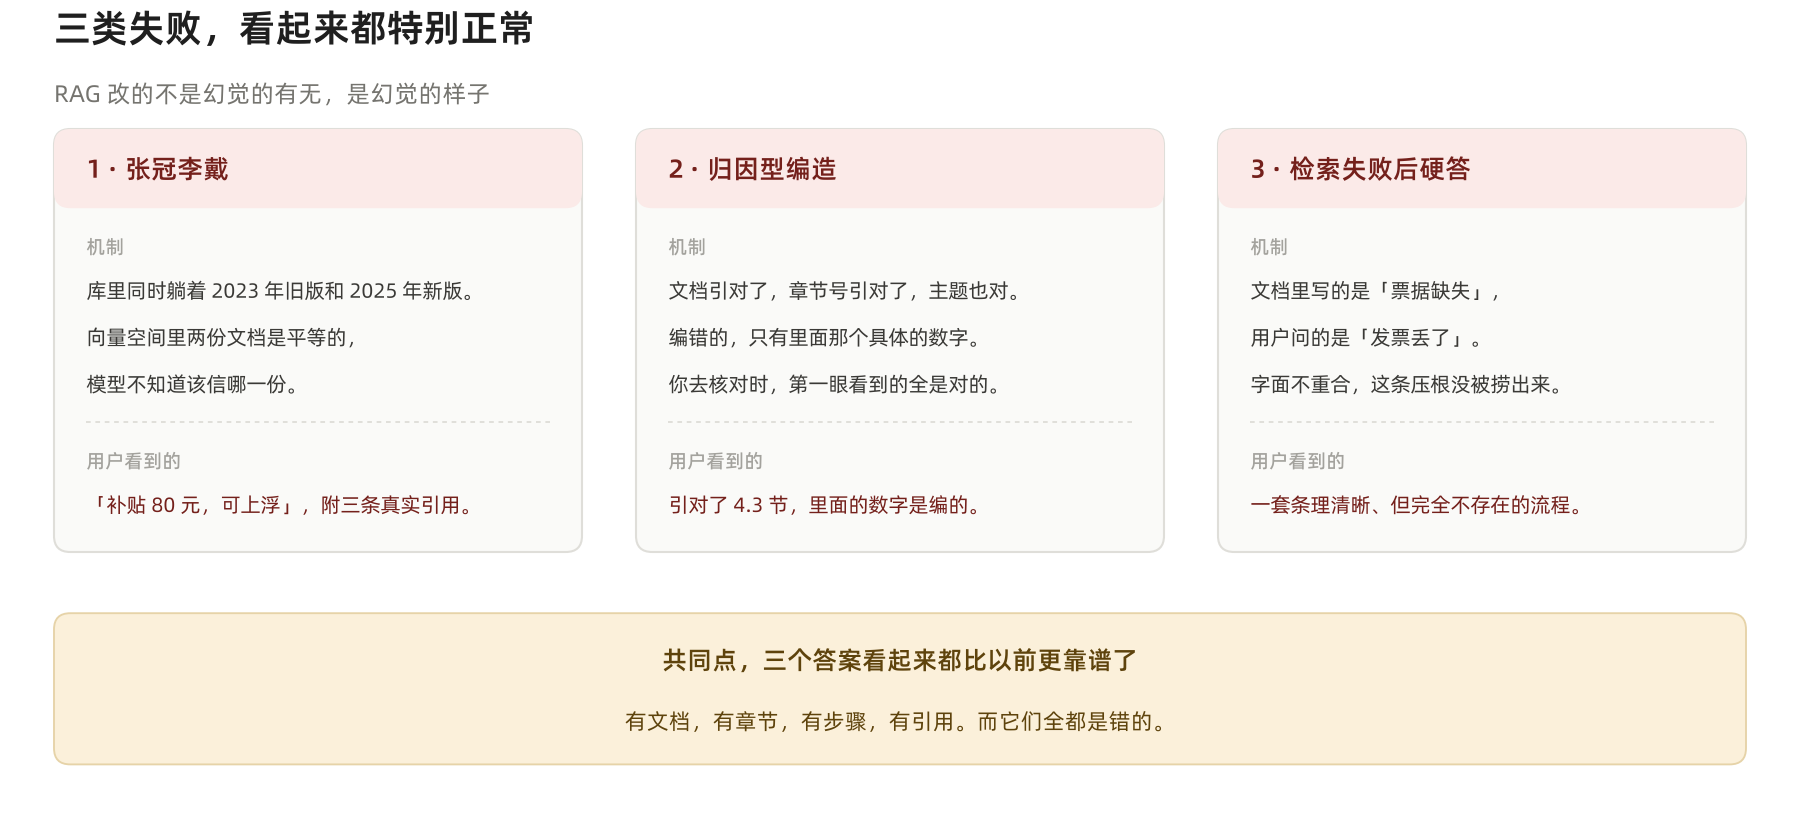
第一个,我管它叫张冠李戴。
假设你在一家公司,内部知识库里有这么三份东西。
一份是《差旅报销标准 V1.0》,2023年修订,里面写着市内交通补贴 80元一天。
一份是《差旅报销标准 V2.0》,2025年1月1日起执行,市内交通补贴提到了 120元一天,附则里还专门写了一句,原 V1.0 同时废止。
还有一份是《财务答疑汇总》,里面有个同事问过一句「市内交通现在还是80吧」,财务回了个「嗯」。
现在你问一句,我下周去杭州出差,市内交通一天能报多少。
这三份文档,向量检索全都算高度相关,全被捞了上来。它们也确实都相关,毕竟都在讲同一件事。
一个没做好的系统会怎么答。
它会说,市内交通补贴是 80 元一天,部分情况下可上浮。
然后给你三条引用,条条都真的,你点进去,都能看到原文。
但正确答案是 120。
这个答案错在哪了。错在它不知道 V1.0 已经作废了。在向量空间里,2023年的旧规定和2025年的新规定,是平等的。模型没有时间的概念,它只知道这两张卡都跟「市内交通补贴」有关,所以它把两条揉成了一条。
这就是 RAG 最典型的失败,张冠李戴。引用越全,越像那么回事。
第二个,更阴一点。
你问,公司的年假没休完怎么算。
AI 回答你,根据《员工手册》第 4.3 节,未休年假按日工资的 200% 折算。
你去翻《员工手册》,第 4.3 节确实存在,标题就是「年休假」。
但里面写的是 150%。
文档是对的,章节号是对的,甚至这一节的主题都是对的。编错的,只有那个数字。
这个失败模式在学术上有个专门的名字,叫归因型编造。意思就是,它不是凭空捏造一个来源,它是从真实的来源里,捏造了一句听起来合理的话。
这种错最难查。因为你核对的时候,第一眼看到的全是对的,你会本能地放下心,然后跳过那个具体的数字。
第三个,是最朴素,也最普遍的一种。
你问,发票丢了怎么报销。
公司的知识库里明明躺着一份《票据遗失与补办流程》,写得清清楚楚,第一步挂失,第二步登报,第三步拿什么材料去财务。
但向量检索没把它捞出来。
原因是,这份文档从头到尾没出现过「发票丢了」这四个字,它用的词是「票据缺失」。
字面上不重合,语义上,也未必贴着。
于是模型手里只剩一堆不相关的材料。它没有说「我没找到相关流程」,它开始自己写。第一步,第二步,第三步,条理清晰,语气笃定。
这个流程是编的。
如果这是你公司的内部系统,有同事照着做了,那笔损失是要他自己承担的。
我把这三个例子摆在一起,是因为它们的共同点特别刺眼。
它们看起来,都比以前更靠谱了。有文档,有章节,有步骤,有引用。
而它们全都是错的。
07 · 那 RAG 到底还值不值得做
写到这里,可能有人要问,那你讲这么多,是不是想说 RAG 是个没用的东西。
不是。
我甚至觉得,它是目前我们手上最像解药的东西。
先说它确实有用的那部分,这个我不能因为要讲失败模式就假装没看见。
斯坦福那组数据里,通用模型 GPT-4 在法律问题上的幻觉率,是 43%。而给他们做专门优化的那些 RAG 工具,做到了 17% 到 34%。通用聊天机器人在法律查询上,之前有研究测出来是 58% 到 82%。
从 82% 到 17%,这不是优化,这是换了个物种。
但我觉得,RAG 真正解决的问题,其实不是幻觉。
它解决的是两个比幻觉更根本的东西。
第一,时效。模型的训练数据有截止日期。昨天发的文件,上个月改的规定,它不知道。这是天生的,没有任何办法。
第二,私有。你公司的内部制度,你家里的那份合同,你写了一半的稿子。这些东西,它这辈子都不可能知道。
幻觉是模型「知道得不够,还硬要说」。时效和私有,是模型「压根不可能知道」。
后两个问题,只有 RAG 能解。
所以我的判断是,RAG 的价值不在于它让 AI 变聪明了,也不在于它让 AI 变诚实了。
它的价值在于,它第一次让 AI 的答案变得可以审计。
以前模型给你一个答案,你没法验证,因为它是从几万亿个参数里搅出来的一团东西,你连它从哪儿来的都不知道。
现在它给你一个答案,还给你三张卡片。这三张卡可能是错的,可能是过期的,可能它压根没看对。但重要的是,你现在有了一个可以翻的地方。
你可以点进去,你可以核对,你可以发现第 4.3 节里写的是 150% 不是 200%。
RAG 给的不是真相,RAG 给的是一个可以被拆穿的谎。
这话听着挺丧的,但我越想越觉得,这已经是个巨大的进步了。
因为我们从来不要求一个人全知全能。我们要求的是,他说的话,我能查。
08 · 那作为普通人,今天能做什么
我前面讲了这么多坑,不是为了劝退,是想让你知道坑长什么样。这一节讲讲具体怎么做,我尽量说得能落地一点。
如果你只是产品的使用者,你今天就能做一件事。
看它给不给你引用,然后真的点进去。
现在很多 AI 产品都说自己有知识库,都说自己在做 RAG。判断真假的方法特别简单,你问一个需要具体资料的问题,然后看两件事。
一,它有没有给你出处。
二,这个出处你点进去,能不能真的找到它引用的那句话。
如果第一条有、第二条也过,那它是真的在做检索。如果它给了一堆引用,你点进去发现链接和它说的内容对不上,那这个引用大概率是它编的,这种产品你就得当心。
这一条动作,今天就能用。
如果你是想自己搭一套,那我给几条我自己的感受。
分块这一步,别用固定长度。
很多人图省事,按字符数切,五百字一块,切到哪儿算哪儿。这个做法便宜,但它会把一句话从中间劈开。你至少得按段落切,能按章节切更好。
检索这一步,别只用向量。
向量擅长找「意思相近」的,但它在找「精确的名字、编号、型号」这些东西上是瞎的。你搜「GB/T 191」,它可能给你捞出一堆讲标准的文档,但没有一份是 GB/T 191 本身。
所以现在大部分做得好的系统,用的是混合检索。向量的归向量,关键词的归关键词,两边结果合起来。这一步不难做,但效果差得挺多。
重排,能加就加。
这一步的性价比很高。前面向量捞回来的十个候选,往往五个是凑数的,重排能把真正对的那两三个顶上来。你在第一步上的所有努力,都会被这一步放大。
捞出来的东西,不要一股脑全塞进去。
这条我要专门说一下,因为它反常识。很多人觉得,多给点资料总没坏处。
不是的。前面那个 U 型曲线的实验已经说得很清楚了,塞得越多,模型越可能瞎。有用的往两头放,不太确定就少放,宁可给三张准的,不要给二十张杂的。
最后一条,也是我觉得最重要的一条。
在提示词里明确写一句,如果检索到的材料不足以回答这个问题,就直接说材料里没有,不要猜。
这句话听起来像废话,但真的管用。前面 OpenAI 那篇论文讲的道理就在这儿,模型之所以会硬答,是因为它被训练成硬答比弃权得分高。你要做的,是在你这一层,把那个激励给掰回来。
你明确告诉它,说不知道不扣分,编答案才扣分。它的行为是会发生变化的。
至于评估,如果你真的要认真做,我建议至少分两个指标测。一个是忠实度,看它说的话有没有超出你给的材料。另一个是相关性,看它有没有正面回答你问的问题。
这两个一定要分开。因为一个答案完全忠实于材料,也可能压根没回答你的问题,它只是把材料复述了一遍。
最后说句实在的。
这套东西听起来没几步,真做起来,你一定会经历一个阶段,就是「我明明把最相关的三份文档放进去了,它还在编」。
这个时候,百分之八十的人第一反应是换模型。换个更贵的,换个更新的。
但按我的经验,十次里有八次,问题不在模型那一层,在检索那一层。它压根没看到你以为它看到的东西。
这话听着挺打击人的,但知道这一点,能帮你省下很多钱。
09 · 其实我们一直都是这么活着的
聊到最后,我想扯远一点。
我们看 RAG 的时候,很容易把它当成一个技术方案,一个给 AI 打的补丁。
但我越琢磨越觉得,它其实是让 AI 第一次开始用我们的方式活着。
你想想看,人是怎么积累知识的。
不是靠每个个体把所有的东西都背下来。一个医生背不下所有药典,一个律师背不下所有判例,一个木匠背不下所有榫卯的做法。我们做的是另一件事。我们把知识写下来,编上号,放到一个能被找到的地方,然后教会后面的人,去那个地方找。
图书馆,就是人类最早的 RAG。
我们从来没有要求一个人全知全能。我们要求的,是他说的话我能查。医生开的方子我能对着药典看,律师引的判例我能去查原文,会计报的税我能翻到那一条规定。
可查,才是可信的全部。
所以 AI 的幻觉问题,说到底不是「它会不会说错」。它一定会说错,人也会说错。
真正的问题是,它说错的时候,你能不能发现。
以前不能。它给你一个答案,你只能选择信或者不信,中间没有第三个选项。
现在可以了。它给你一个答案,还给你几张卡片。卡片可能是旧的,可能是错的,可能它压根没看对。
但至少,谎话有了一个可以被拆穿的形式。
我把这话再往深了推一层。
闭卷考考的是记忆。开卷考考的是判断力。
而判断力,恰恰是这场考试里最难的那部分。
AI 现在真正缺的,可能不是知道得太少,是它不知道该信哪一条。它面前摊着三份文档,一份是2023年的,一份是2025年的,一份是同事随口问了句「还是80吧」。它没有能力判断,哪一份该信,哪一份该扔。
这是它现在的短板。而这件事,恰恰是我们最擅长的。
回到最开始那个律师。
Schwartz 输,不是因为他用了 AI。是因为,AI 给了他六个案子,他一个都没有去查。
他信了。
开卷考把书递到了你手上,翻不翻,还是你自己的事。
能做的,还是那句话。
磨平一点点信息差。哪怕,只是很小很小的一点。
那就够了。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标。
谢谢你看我的文章,我们,下次再见。
附 · 本文引用数据来源
- 律师 Steven Schwartz 引用六个虚构判例、法官 P. Kevin Castel 裁定、罚款 5000 美元(2023)· 美国纽约南区联邦法院制裁令;《纽约时报》2023年报道
- 斯坦福 RegLab / HAI 法律 AI 工具幻觉率测评(Lexis+ AI 与 Ask Practical Law AI 超 17%、Westlaw AI-Assisted Research 超 34%、GPT-4 通用 43%)· Magesh et al.,「Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools」,《Journal of Empirical Legal Studies》2025
- 通用聊天机器人在法律查询上的幻觉率 58%–82% · 斯坦福 HAI 前序研究
- 模型被训练成「宁可猜也不弃权」、o4-mini 与 gpt-5-thinking-mini 的弃权率/错误率对比、主流评测奖励幻觉行为 · Kalai, Nachum, Vempala, Zhang,「Why Language Models Hallucinate」,OpenAI,2025年9月4日
- RAG 概念起源 · Lewis et al.,「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」,Facebook AI Research,2020
- 标准向量检索在干净语料上,正确答案未能进入前 20 名的比例 5.7% · Anthropic 上下文检索(Contextual Retrieval)技术说明
- 医学领域 RAG 研究,前 16 个检索段落中仅 22% 与问题真正相关 · 2025年11月,18 位医学专家参与、80,502 条标注、800 份 RAG 输出
- 长上下文位置的 U 型曲线、GPT-3.5-Turbo 多文档问答闭卷准确率 56.1% · Liu et al.,「Lost in the Middle: How Language Models Use Long Contexts」,TACL 2023
- 18 款模型随输入变长性能普遍下降(「上下文腐烂」)· Chroma Research,「Context Rot: How Increasing Input Tokens Impacts LLM Performance」,2025年7月
- RAG 场景下前沿模型幻觉率,最好者约 6.3%–6.7%,多款模型在 10%–16% 区间 · Vectara × 滑铁卢大学 FaithJudge 榜单(EMNLP 2025 Industry Track)
- 面对全不相关文档时模型拒答率最高仅 45% · RGB(Retrieval-Augmented Generation Benchmark)评测
- 检索材料与模型已有正确答案冲突时,超 60% 情况模型放弃正确答案 · ClashEval 评测
- 父子块切分(parent-child chunking)将检索精度由 54% 提至 81% · 行业实践数据,出处强度中等,引用时建议注明为实践报告口径
注一 · 第 06 章的三组内部知识库案例,为便于说明失败机制而构造的演示场景,非真实企业案例,仅用于解释「张冠李戴」「归因型编造」「检索失败后硬答」三类错误。
注二 · RAG 流程中的父子块精度数据来自行业实践报告,未经同行评审,正文中已弱化表述,如需引用请自行核实原始出处。
注三 · 第 04 章中关于分块、嵌入、重排的实操建议为作者经验判断,非唯一正确答案,不同语料下的最优参数差异很大。
本文作者:Samjoe Yang
本文链接: https://need.uno/ai-zui-da-de-huang-yan-shi-you-chu-chu-de/
版权声明:本作品采用 知识共享署名-相同方式共享 4.0 国际许可协议 进行许可。
评论